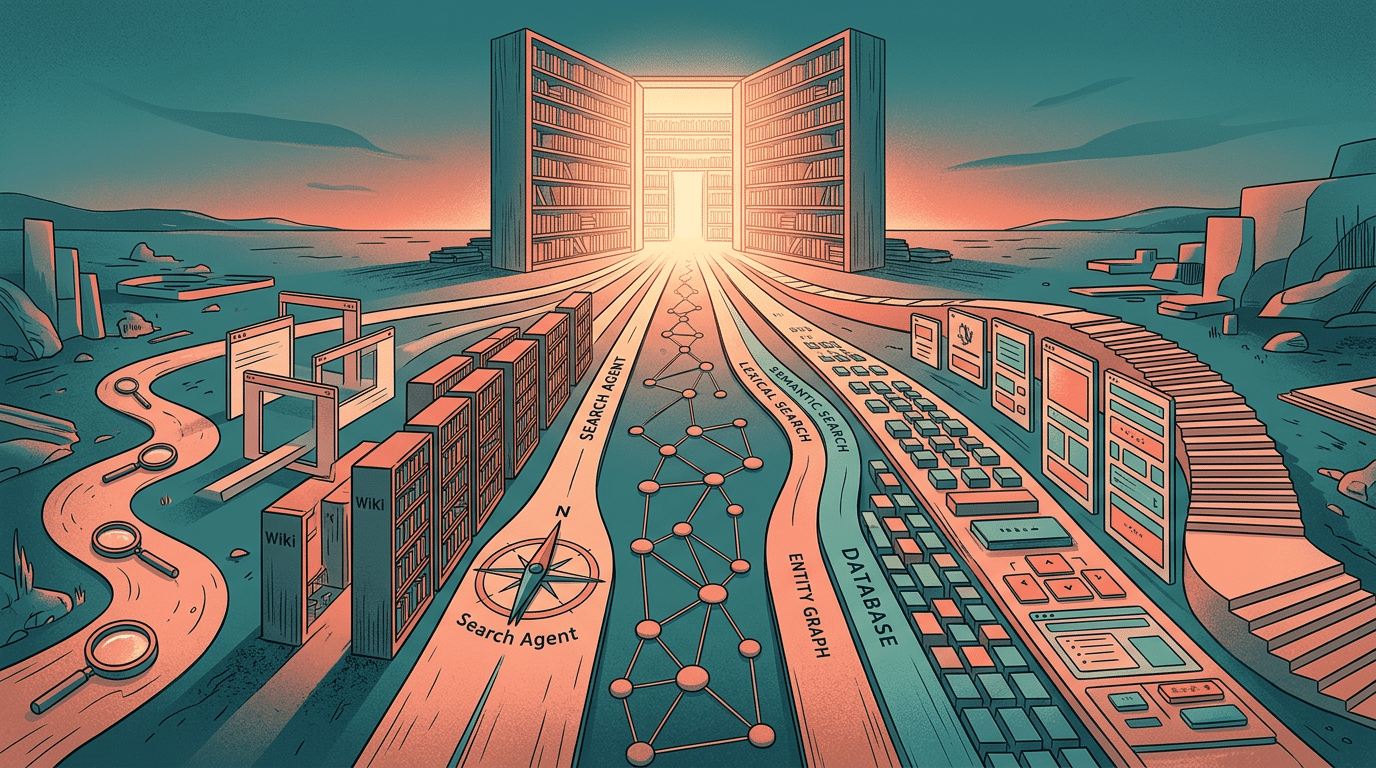
RAG ficou obsoleto? A resposta curta é: não. O que ficou insuficiente, em alguns cenários, é o RAG simples, com uma busca vetorial única, um top-k fixo e a esperança de que os melhores trechos apareçam sozinhos.
RAG continua sendo uma peça excelente para conectar um modelo a documentos que não cabem na memória do modelo. O artigo que apresentou o RAG original já tratava essa combinação como uma memória paramétrica, formada pelo modelo, com uma memória externa, consultada durante a resposta. Hoje, porém, essa memória pode ser uma tabela, uma wiki, um grafo, uma ferramenta ou um documento inteiro.
As nove opções abaixo não são nove substitutos isolados. Elas se combinam. O ponto é escolher com calma: qual é o formato da fonte, qual é o tamanho e a velocidade de mudança, que tipo de pergunta aparece, quão importante é a atualização, que evidência precisa ser mostrada, qual latência cabe, qual é o orçamento, como funciona o controle de acesso e qual é o risco de uma resposta errada.
1. RAG tradicional: o ponto de partida
Como funciona. A ingestão coleta os documentos, divide cada arquivo em trechos, transforma cada trecho em um vetor de significado, grava esses vetores em um índice e, na pergunta, recupera os top-k mais parecidos. Esses trechos entram no contexto do modelo, que redige a resposta com base neles e, idealmente, devolve a referência da origem.
Onde ganha. É uma escolha prática para muitos documentos com perguntas locais: “qual é o prazo da garantia?”, “como abrir um chamado?” ou “qual é a regra para reembolso?”. A recuperação evita enviar todo o acervo em cada pergunta e permite incorporar documentos novos sem treinar novamente o modelo.
Onde falha. Um trecho pode perder o assunto quando é separado do título, da tabela ou da seção que o explicava. O top-k pode ser pequeno demais, a pergunta pode usar uma expressão diferente da fonte e documentos antigos podem continuar no índice. Também é fácil aplicar o controle de acesso depois da busca, tarde demais, ou juntar evidências contraditórias. RAG não elimina alucinações: se a evidência não vier, vier errada ou for ambígua, o modelo ainda pode inventar uma resposta convincente.
Custo dominante. Médio, variando conforme o volume, o modelo de embeddings, o banco vetorial e a infraestrutura. O peso maior costuma estar na ingestão, na atualização do índice e no armazenamento, não apenas na geração final.
Exemplo. Uma central de suporte com milhares de manuais pode indexar procedimentos por produto, recuperar os trechos relevantes e responder com o nome do documento, a seção e a data de revisão. Se os testes mostrarem muitos erros de contexto, vale combinar RAG com busca lexical, resumos ou navegação hierárquica.
2. Long Context: enviar o documento inteiro
Como funciona. Em vez de recuperar trechos, o sistema coloca um documento inteiro, ou um conjunto pequeno de documentos, no contexto do modelo. A abordagem funciona quando o corpus cabe com folga na janela disponível. “Com folga” importa: ainda é preciso espaço para a pergunta, instruções, histórico e resposta.
Onde ganha. Preserva relações entre seções, exceções, tabelas e definições que uma divisão em trechos pode quebrar. Para revisar um contrato curto, comparar duas políticas ou responder perguntas sobre um manual de poucas páginas, enviar o material completo pode ser mais simples e mais confiável do que construir uma cadeia de ingestão.
Onde falha. A capacidade nominal da janela não é a mesma coisa que a recuperação efetiva da evidência. Um modelo pode aceitar centenas de milhares de tokens e ainda deixar passar um detalhe importante. O efeito Lost in the Middle, estudado em avaliações sobre a posição da evidência em contextos longos, mostra que a informação no meio do contexto pode ser usada pior do que a informação no começo ou no fim. Repetir documentos também aumenta ruído, latência e chance de contradição.
Custo dominante. Baixo para um corpus pequeno e estável, mas pode ficar alto conforme o volume, o modelo e a infraestrutura. O custo vem dos tokens enviados, da latência e da necessidade de repetir ou armazenar o mesmo contexto em muitas perguntas.
Exemplo. Uma equipe jurídica analisa um contrato de 80 páginas durante uma sessão de perguntas concentrada. O documento inteiro pode bastar. Já um repositório com anos de contratos, aditivos e versões provavelmente precisa de recuperação, filtros por data e controle de acesso.
3. Wiki-Based: conhecimento curado e navegável
Como funciona. Uma wiki organiza páginas com títulos, categorias, links de retorno, histórico de revisão e navegação. Ela pode ser pública ou privada. Não é um algoritmo único: a aplicação pode usar busca lexical, uma API, links entre páginas, SQL, RAG ou uma mistura desses mecanismos. A API de busca do MediaWiki, por exemplo, oferece busca textual, filtros de espaço nominal e ordenação por relevância.
Onde ganha. A força está na autoria, na taxonomia e na manutenção editorial. Em vez de transformar todo conhecimento em uma pilha anônima de trechos, a empresa consegue dizer quem mantém uma página, quando ela foi revisada, quais conceitos se relacionam e qual caminho de navegação o leitor deve seguir.
Onde falha. Uma wiki não descobre fatos internos que nunca foram documentados. Páginas abandonadas ficam desatualizadas, e o controle de acesso granular pode ser mais difícil quando uma página mistura informações para públicos diferentes. Também não se deve confundir o conhecimento geral da Wikipedia com uma fonte confiável para dados, regras e decisões da sua empresa.
Custo dominante. Médio, condicionado ao volume, ao fluxo editorial e à infraestrutura de busca. O custo principal não é apenas técnico: é manter responsáveis, revisão, taxonomia e políticas claras para páginas antigas.
Exemplo. Uma empresa de engenharia mantém uma wiki privada com padrões de arquitetura, decisões registradas e procedimentos operacionais. O assistente pode começar pela página certa, seguir os links relacionados e usar RAG apenas para trechos extensos. Para uma FAQ pequena e bem mantida, a wiki com busca e revisão talvez já seja suficiente.
4. Agentic Search: buscar em várias rodadas
Como funciona. Um agente decide se precisa buscar, escolhe onde buscar, divide a pergunta em etapas, faz novas consultas a partir do que encontrou, compara evidências e encerra quando um critério de parada é atingido. Esse fluxo troca uma recuperação fixa por uma política adaptativa.
Onde ganha. É útil em perguntas de múltiplos saltos, nas quais a resposta depende de descobrir uma entidade antes de procurar a próxima relação. Pesquisas sobre recuperação intercalada com raciocínio em perguntas multi-hop exploram justamente essa alternância: o que buscar na próxima rodada depende do que já foi descoberto.
Onde falha. Sem limites, a latência e o custo ficam imprevisíveis. Uma busca ruim pode contaminar a etapa seguinte, criando erro em cascata. Fontes externas também podem conter instruções maliciosas para o agente, um risco conhecido como prompt injection. É necessário separar conteúdo da fonte de instruções do sistema, limitar domínios e chamadas, registrar cada passo e definir quando o agente deve admitir que não encontrou evidência.
Custo dominante. Alto, dependendo do volume, do modelo e da infraestrutura, porque cada pergunta pode gerar várias chamadas de busca e várias chamadas ao modelo. O trabalho de definir limites, observabilidade e recuperação de falhas também pesa.
Exemplo. Para investigar por que uma entrega atrasou, o agente pode consultar o pedido, cruzar o código de transporte, verificar a ocorrência e então procurar a política aplicável. O trabalho de busca adaptativa com reflexão reforça a ideia de recuperar apenas quando necessário e avaliar a qualidade do que foi recuperado. Isso melhora o processo em tarefas específicas, mas não transforma o agente em uma garantia automática de verdade.
5. GraphRAG: entidades, relações e visão do conjunto
Como funciona. O sistema extrai entidades e relações dos documentos, constrói um grafo e agrupa entidades próximas em comunidades. Depois, gera resumos dessas comunidades e usa os resumos para responder perguntas locais ou globais. O trabalho da Microsoft sobre GraphRAG e resumo orientado por consulta descreve essa passagem do detalhe local para uma visão do conjunto.
Onde ganha. O grafo ajuda quando a pergunta é sobre padrões, conexões ou temas espalhados por um corpus grande: “quais problemas aparecem em várias áreas?”, “quais projetos dependem do mesmo fornecedor?” ou “quais grupos de clientes são afetados por esta mudança?”. A estrutura explícita facilita percorrer relações que uma similaridade entre trechos pode não capturar.
Onde falha. Extração de entidades e relações pode produzir fatos errados. Além disso, a indexação inicial, a atualização do grafo, a geração de resumos e a governança das relações custam tempo e infraestrutura. Um grafo desatualizado pode parecer mais organizado do que uma fonte bruta, mas continuar errado.
Custo dominante. Alto, condicionado ao volume, ao modelo e à infraestrutura. O custo aparece na extração, no armazenamento, na atualização incremental e na revisão das relações. Para uma FAQ simples, GraphRAG normalmente é complexidade sem ganho medido.
Exemplo. Uma empresa farmacêutica investiga relações entre compostos, estudos, efeitos adversos e fornecedores ao longo de milhões de tokens. O grafo pode revelar comunidades e conexões que uma pergunta vetorial isolada perderia. Para “qual é o prazo de reembolso?”, um índice simples é melhor.
6. Hybrid Search: lexical e semântica juntas
Como funciona. A busca híbrida combina busca lexical, como BM25, com busca vetorial. A primeira privilegia palavras e expressões exatas; a segunda procura proximidade de significado. Os resultados podem ser unidos por fusão de posições e, opcionalmente, reordenados por um modelo de reranking.
Onde ganha. É especialmente útil quando a pergunta mistura semântica com nomes próprios, siglas, códigos de erro, identificadores e números de versão. Uma busca vetorial pode entender “falha de autenticação”, mas perder o código exato TS-999. O BM25 pode encontrar o código, enquanto os vetores ampliam a busca para descrições equivalentes. A explicação da busca híbrida com BM25, embeddings e reranking mostra como essas camadas podem ser combinadas.
Onde falha. Dois índices significam duas superfícies para monitorar. A fusão de resultados, o tamanho das listas e o reranker exigem ajuste. Mais camadas também podem aumentar a latência. Não é correto afirmar que a busca híbrida sempre supera uma busca única: o resultado depende do idioma, do domínio, da qualidade dos índices e das perguntas reais.
Custo dominante. Médio, variando conforme volume, modelos e infraestrutura. O custo dominante costuma ser manter o índice lexical e o vetorial, além do reranker quando ele é necessário.
Exemplo. Uma base de suporte recebe perguntas como “como configurar o serviço de identidade?” e “o que significa o erro AUTH-4037?”. A busca híbrida cobre os dois casos sem obrigar a equipe a escolher entre correspondência exata e entendimento semântico.
7. SQL e recuperação estruturada: calcular antes de explicar
Como funciona. Quando a fonte tem esquema, chaves, tipos e regras bem definidos, a recuperação pode usar filtros, junções e agregações determinísticas. O banco calcula; o modelo explica o resultado. Para saber o faturamento mensal, por exemplo, o sistema deve somar os lançamentos no banco, não procurar um parágrafo parecido em um documento.
Onde ganha. Números, contagens, médias, totais e filtros temporais ficam mais auditáveis quando saem de uma consulta. A documentação do PostgreSQL sobre funções de agregação SQL mostra como operações como count, sum, avg, max e min produzem resultados sobre várias linhas.
Onde falha. O custo está no esquema, na construção e validação das consultas e nas permissões. Um sistema de texto para SQL livre pode escolher a coluna errada, interpretar mal uma data ou consultar dados demais. Use conexão somente leitura, parâmetros, limites de linhas, listas de tabelas permitidas e validação antes da execução. A resposta numérica deve vir da consulta executada, não de trechos semelhantes.
Custo dominante. Médio, dependendo do volume, do modelo e da infraestrutura do banco. Consultas bem indexadas podem ser baratas; governança, auditoria e manutenção do esquema são o investimento contínuo.
Exemplo. Para “qual foi o faturamento de março por região?”, o sistema filtra o período, agrupa por região e retorna os números. O modelo transforma o resultado em uma explicação, informa o período e aponta os filtros usados, mas não recalcula o valor na imaginação.
8. MCP e ferramentas: dados vivos sob permissão
Como funciona. O MCP padroniza como um servidor expõe recursos e ferramentas para um sistema de IA. A especificação descreve recursos e ferramentas MCP: recursos fornecem dados ou contexto, enquanto ferramentas executam funções. O modelo ou o hospedeiro escolhe chamadas de acordo com as permissões disponíveis.
Onde ganha. É uma boa opção para dados vivos, sistemas operacionais e funções que não fazem sentido copiar para um índice: consultar o estoque atual, buscar o status de um pedido ou ler um calendário autorizado. O mesmo contrato pode conectar diferentes clientes a serviços diferentes.
Onde falha. MCP é transporte e interface, não algoritmo de ranqueamento e nem certificado de veracidade. Uma ferramenta pode retornar dados atrasados, incompletos ou incorretos. Chamadas externas também falham, ficam indisponíveis ou exigem autenticação. Recursos de leitura devem ser tratados de forma diferente de ferramentas que alteram estado, enviam mensagens, criam registros ou geram efeitos financeiros.
Custo dominante. Médio, podendo ser alto conforme o volume, o modelo e a infraestrutura. O custo inclui chamadas adicionais, disponibilidade, observabilidade e segurança. Para cada ferramenta de escrita, defina confirmação explícita, escopo mínimo e registro de auditoria.
Exemplo. O assistente pode consultar o saldo de estoque como leitura e, separadamente, preparar uma ordem de compra. A consulta pode ser automática; a ação com efeito externo deve exigir autorização clara e mostrar os dados que serão usados.
9. Recuperação hierárquica: do resumo ao detalhe
Como funciona. O índice é organizado em níveis: resumos gerais, comunidades ou seções, e trechos originais. A consulta começa pelo nível mais amplo e navega até o detalhe necessário. O método RAPTOR, por exemplo, cria uma árvore de resumos ao agrupar e resumir trechos recursivamente.
Onde ganha. Essa estrutura ajuda em documentos longos e perguntas que exigem visão geral e detalhe ao mesmo tempo. Um relatório pode ser localizado pelo resumo executivo, refinado pela seção de resultados e confirmado no parágrafo original. O sistema não precisa escolher entre entender o tema inteiro e recuperar uma frase isolada.
Onde falha. Resumos custam para gerar e atualizar. A compressão também pode apagar uma exceção, uma condição ou uma nuance importante. Se o resumo estiver errado, ele pode direcionar a navegação para o lugar errado. Por isso, a resposta final deve voltar ao texto original quando a precisão importar.
Custo dominante. Médio a alto, condicionado ao volume, ao modelo e à infraestrutura. A despesa vem da geração dos resumos, da atualização de vários níveis e da manutenção dos vínculos entre resumo e fonte.
Exemplo. Uma equipe analisa relatórios anuais extensos e pergunta tanto “quais foram os principais riscos?” quanto “qual nota explica o risco de liquidez?”. A camada superior responde à primeira; a navegação até o trecho original sustenta a segunda.
Uma matriz compacta para escolher
- Documentos numerosos e perguntas locais: RAG tradicional; custo dominante médio de ingestão, índice e atualização; melhor caso é localizar trechos específicos com referência.
- Corpus pequeno e estável: Long Context; custo dominante baixo no volume pequeno, mas crescente em tokens e latência; melhor caso é enviar documentos inteiros sem quebrar contexto.
- Conhecimento editorial e navegável: Wiki-Based; custo dominante médio de manutenção e revisão; melhor caso é uma base com autoria, categorias e histórico.
- Perguntas com vários saltos: Agentic Search; custo dominante alto por múltiplas chamadas e controle operacional; melhor caso é investigar, buscar, verificar e parar com critério.
- Relações e padrões em corpus grande: GraphRAG; custo dominante alto de extração, atualização e governança; melhor caso é responder perguntas locais e globais sobre conexões.
- Nomes, siglas, IDs e significado: Hybrid Search; custo dominante médio de dois índices, fusão e eventual reranking; melhor caso é combinar correspondência exata e semântica.
- Dados com esquema e números: SQL; custo dominante médio de esquema, permissões e consultas; melhor caso é filtrar, juntar e agregar com resultado determinístico.
- Dados vivos e ações autorizadas: MCP e ferramentas; custo dominante médio ou alto de chamadas, segurança e disponibilidade; melhor caso é consultar sistemas atuais e separar leitura de ação.
- Documentos longos com visão geral e detalhe: recuperação hierárquica; custo dominante médio a alto de resumos e atualização; melhor caso é navegar do panorama até a evidência original.
Três cenários que deixam a escolha mais concreta
FAQ de políticas. Imagine uma empresa com centenas de páginas de políticas, códigos internos e perguntas curtas. O ponto de partida pode ser uma busca híbrida com BM25 e vetores, seguida de reranking para reduzir os trechos enviados ao modelo. Títulos, datas de vigência e grupos autorizados devem acompanhar cada resultado. Se as políticas forem poucas e a equipe mantiver uma wiki organizada, a wiki com busca pode bastar antes de qualquer arquitetura mais pesada.
BI e faturamento. Para perguntas sobre receita, margem, quantidade de pedidos ou faturamento mensal, use SQL somente leitura, com consultas parametrizadas e limites. O banco calcula filtros, junções e agregações; o modelo explica o resultado em linguagem natural e informa o período, as dimensões e eventuais dados ausentes. Um RAG sobre relatórios pode complementar a explicação, mas não deve substituir a consulta que produziu o número.
Investigação multi-hop. Para descobrir relações entre incidentes, serviços, responsáveis e mudanças de código, um agente pode consultar várias fontes em rodadas controladas. Se o corpus for grande e as relações forem centrais para a pergunta, um grafo pode organizar entidades e comunidades. O agente decide quais caminhos explorar; o grafo oferece estrutura; os documentos originais fornecem a evidência. Limites de chamadas, autorização por fonte, registro dos passos e critério de parada são obrigatórios.
Quando Long Context ou uma wiki já bastam
Long Context é uma boa escolha quando há poucos documentos, eles cabem com folga, mudam pouco e a tarefa depende de relações que seriam quebradas pela divisão em trechos. É também uma maneira rápida de validar uma ideia antes de investir em ingestão e índices. Quando o mesmo material é consultado muitas vezes ou começa a crescer, o custo de repetir tokens e a dificuldade de localizar evidência tendem a pedir recuperação.
Uma wiki basta quando o conhecimento é curado, tem dono, possui uma taxonomia compreensível e precisa ser lido e mantido por pessoas. Ela pode oferecer busca, links, revisão e API sem transformar cada página em um índice vetorial. Se a pergunta exige cálculos, dados vivos ou fatos que nunca foram documentados, a wiki não resolve sozinha; nesse caso, conecte a fonte adequada em vez de encher páginas com cópias frágeis.
Checklist de avaliação
Antes de escolher a arquitetura, monte um conjunto de perguntas reais, incluindo perguntas fáceis, ambíguas, sem resposta e com documentos conflitantes. Depois, avalie o comportamento observável:
- Recuperação da evidência: o sistema encontrou o documento e o trecho corretos?
- Resposta fundamentada: a resposta usa apenas o que a fonte sustenta?
- Citação: a pessoa consegue abrir a origem, entender o contexto e verificar a data?
- Atualização: uma mudança na fonte aparece no prazo necessário?
- Autorização: cada pessoa vê apenas o que pode consultar, inclusive em índices, grafos e ferramentas?
- Latência p95: o tempo no pior grupo de respostas atende ao produto?
- Custo por resposta: o gasto de tokens, chamadas, armazenamento e operação cabe no orçamento?
- Abstenção: o sistema admite que a fonte não sustenta a resposta, em vez de preencher a lacuna?
O resultado desses testes vale mais do que a moda do momento. RAG não ficou obsoleto; ele deixou de ser uma resposta universal. Comece pelo mecanismo mais simples que passa nas perguntas reais, com evidência e autorização corretas. Combine padrões apenas quando o ganho aparecer nos números: melhor recuperação, melhor fundamento, atualização aceitável, latência dentro do limite e custo que faça sentido.
Autor

flpchapola@hotmail.com
Posts relacionados
Agentes de IA com limites: como desenhar autonomia sem perder o controle
Um agente útil não precisa fazer tudo sozinho: limites claros, checkpoints e ferramentas pequenas tornam a autonomia segura e previsível.
Leia tudo
Observabilidade para agentes de IA: como saber o que o agente realmente fez
Resultado certo não prova processo certo. Logs, traces de ferramentas e custo por tarefa para você parar de torcer e começar a...
Leia tudo
Mais código, mesmo software: o gargalo da revisão na era dos agentes de IA
Estudo de Harvard com 300 milhões de eventos mostra: agentes de IA aumentam commits e PRs, mas a revisão humana absorve o...
Leia tudo
Skills vs MCP: quando usar cada um no seu fluxo com agentes de IA
MCP conecta seu agente ao mundo; Skills ensinam o agente a trabalhar do seu jeito. A diferença prática entre ferramentas e receitas...
Leia tudo
Inteligência Artificial Vai Substituir Programadores?
A inteligência artificial (IA) e o machine learning (ML) estão transformando o mundo da tecnologia, criando novas oportunidades e desafios para profissionais...
Leia tudo
OpenAI Lança SearchGPT e Desafia Google com Nova Ferramenta de Busca Revolucionária
A OpenAI lançou oficialmente seu mecanismo de busca, num ataque direto ao Google. Depois de pegar a dona do YouTube de calças...
Leia tudo