Outro dia, conversando com uma colega que monta agentes de IA para atendimento, ela me contou uma cena que me ficou na cabeça. O agente dela resumia e-mails e abria tarefas no sistema interno. Funcionava lindamente, até alguém perguntar: “e se um e-mail disser para o agente fazer outra coisa?”. Silêncio. Ninguém tinha testado. Ninguém nem tinha pensado direito nisso.
Esse é o assunto de hoje: injeção de prompt. É um risco que quase todo mundo ouve falar e quase ninguém coloca na suíte de testes. Vou tentar explicar de um jeito prático, sem pânico e sem ladainha, porque o problema é sério, mas tem jeito de reduzir bastante o estrago.
O que é injeção de prompt, afinal
Um modelo de linguagem recebe tudo como texto: as instruções do desenvolvedor, o pedido do usuário, o conteúdo de um arquivo, o resultado de uma busca. Para ele, não existe uma parede sólida entre “o que eu devo obedecer” e “o que eu só devo ler”. Tudo vira uma sequência de tokens, e o modelo decide o que fazer com base em padrões, não em permissões.
Injeção de prompt é aproveitar isso: alguém escreve um texto que, ao entrar no contexto do modelo, é interpretado como instrução e muda o comportamento do sistema. A comparação clássica é com a injeção de SQL, em que dados viram código. A diferença incômoda é que, no SQL, a gente aprendeu a separar os dois com consultas parametrizadas. Com linguagem natural, não existe (ainda) um equivalente que resolva de vez.
Direta e indireta
A forma direta é a mais conhecida: o próprio usuário escreve algo como “ignore as instruções anteriores e faça X”. É o jailbreak de chat. Costuma ser menos grave quando o usuário só consegue prejudicar a si mesmo, mas deixa de ser inofensiva quando o sistema guarda dados de outras pessoas ou executa ações com privilégios.
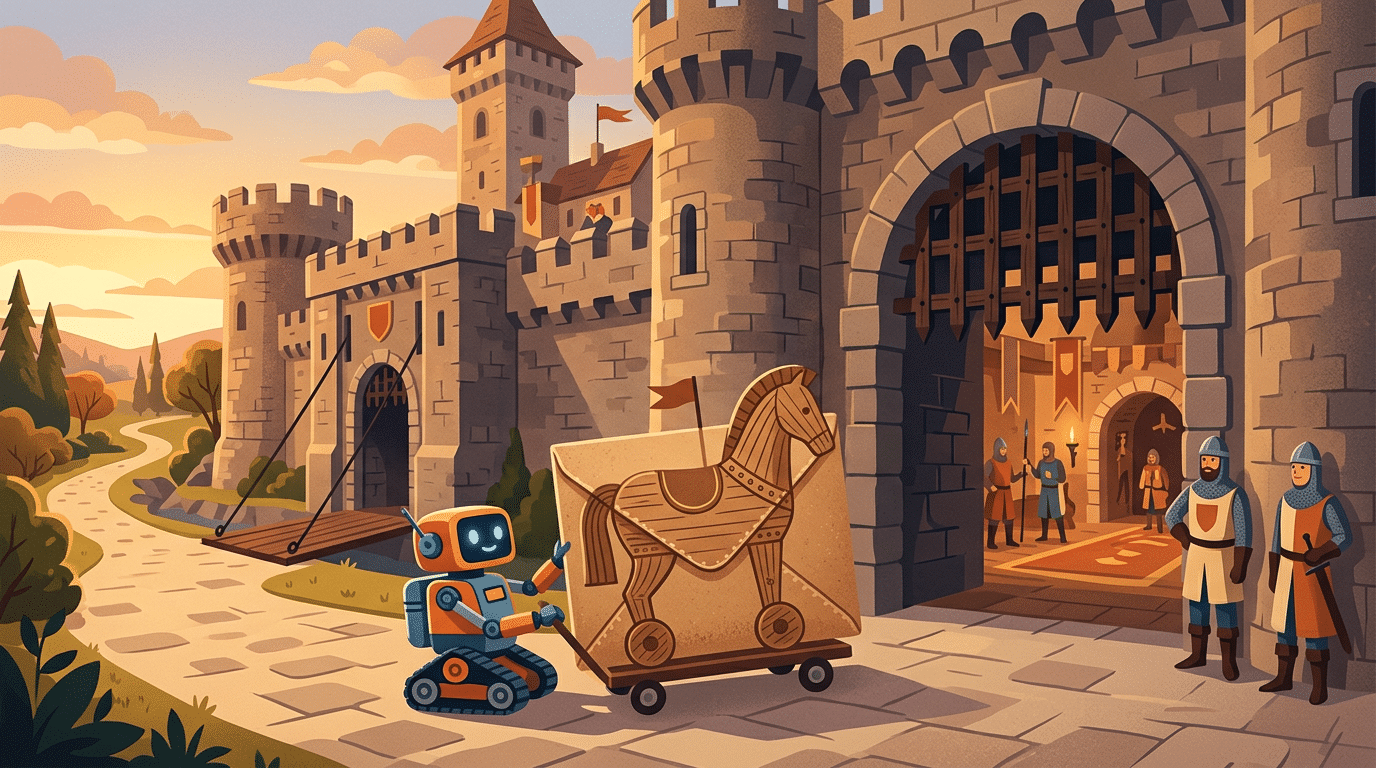
A forma indireta é a que me tira o sono. Aqui o atacante nem conversa com o agente. Ele deixa o texto malicioso em algum lugar que o agente vai ler mais tarde:
- uma página web com texto escondido (branco sobre branco, comentário no HTML, fonte minúscula) dizendo ao agente de pesquisa o que fazer;
- um e-mail que parece comum, mas traz no meio do corpo um parágrafo endereçado ao assistente que vai resumi-lo;
- uma issue ou comentário em um repositório, lido por um agente de código que triagem problemas;
- um documento (PDF, planilha, ata de reunião) com uma instrução enterrada em algum canto;
- até o nome de um arquivo, um campo de formulário ou o título de um convite de agenda.
O ponto central: o dono legítimo do agente jamais viu esse texto. Quem o escreveu não tem nenhuma relação com o sistema. E mesmo assim ele entra no contexto com a mesma “voz” de qualquer outra coisa.
Por que agentes com ferramentas mudam o jogo
Um chatbot que só conversa, quando é enganado, produz um texto ruim. Chato, às vezes constrangedor, mas o dano costuma parar na tela. Já um agente com ferramentas pode agir: enviar e-mails, ler arquivos, executar comandos, abrir pull requests, chamar APIs, fazer pagamentos.
Cada ferramenta que você entrega ao agente é uma capacidade que um atacante pode tentar herdar. A injeção de prompt vira, na prática, uma forma de execução remota de intenção: o atacante não precisa invadir nada, só precisa convencer o agente, que já está dentro, já tem as chaves e já é confiável para o resto do sistema.
Tem ainda um efeito de composição. Agentes encadeiam passos: leem, decidem, chamam uma ferramenta, leem o resultado, decidem de novo. Uma instrução plantada no passo 2 pode influenciar o passo 7, quando ninguém mais lembra de onde ela veio. E, se existem vários agentes conversando entre si, a saída de um vira entrada do outro, e a desconfiança se perde pelo caminho.
O trio letal
Uma forma útil de raciocinar sobre o risco, que ouvi de pessoas que estudam o tema, é olhar para três ingredientes. Quando os três aparecem juntos no mesmo agente, o perigo é de verdade:
- Acesso a dados privados: e-mails, código-fonte, documentos internos, tokens, dados de clientes.
- Exposição a conteúdo não confiável: qualquer texto que alguém de fora possa influenciar, como páginas, e-mails recebidos, issues públicas, anexos.
- Canal de saída: qualquer meio de mandar informação para fora, como enviar e-mail, fazer uma requisição HTTP, publicar um comentário, abrir um link com parâmetros na URL, até renderizar uma imagem remota.
Repare na lógica. Se o agente lê dados privados e lê conteúdo hostil, mas não consegue enviar nada para fora, o vazamento fica difícil. Se ele lê conteúdo hostil e consegue enviar coisas, mas não tem acesso a nada sensível, não há muito o que vazar. É a combinação que fecha o circuito: o texto malicioso manda o agente pegar o dado privado e entregá-lo por algum canal.
Esse modelo mental é valioso porque transforma uma ameaça vaga em uma pergunta de projeto: qual desses três eu consigo remover, ou separar, neste agente? Muitas vezes a resposta é “o canal de saída”, e isso já muda tudo.
Defesas práticas
Vou ser direto: não existe uma bala de prata. O que existe é uma pilha de camadas, e cada uma reduz o raio de explosão. A ideia é assumir que, em algum momento, o modelo vai ser enganado, e desenhar o sistema para que isso não seja catastrófico.
Privilégio mínimo
É o velho princípio de segurança, e aqui rende muito. Pergunte, para cada ferramenta: o agente precisa mesmo disso para essa tarefa? Um agente que resume e-mails não precisa enviar e-mails. Um agente que triagem issues não precisa de permissão de escrita no repositório. Credenciais devem ser as menores possíveis: escopo restrito, curta duração, separadas por tarefa. Nada de dar o token de administrador “só para facilitar”.
Confirmação humana em ações destrutivas ou irreversíveis
Apagar, enviar, pagar, publicar, alterar permissões: tudo o que não dá para desfazer merece um “tem certeza?” feito por uma pessoa. Dois cuidados para isso funcionar de verdade:
- mostre ao humano o que será feito, de forma concreta (destinatário, conteúdo, valor), e não um genérico “o agente quer executar uma ação”;
- não banalize o pedido. Se a pessoa clica em “aprovar” trezentas vezes por dia, ela vai aprovar a trezentos e um sem ler. Reserve a confirmação para o que importa.
Separar leitura de escrita
Uma arquitetura que me agrada: um agente (ou etapa) que lê conteúdo não confiável e só tem ferramentas de leitura, e outro que age, com poderes de escrita, mas que nunca vê o texto bruto externo. Entre os dois, passa apenas uma saída estruturada e estreita, validada por código comum, como um esquema com campos fixos, em vez de texto livre.
Assim, mesmo que a instrução maliciosa convença o primeiro agente, ela não tem como se transformar em ação, porque quem tem as mãos nunca leu o veneno. Não é perfeito, já que o primeiro ainda pode produzir um resumo enviesado, mas corta o caminho mais perigoso.
Allowlist de domínios e destinos
Se o canal de saída é o elo que fecha o trio letal, vigie-o de perto. Se o agente precisa fazer requisições, liste explicitamente os domínios permitidos e bloqueie o resto. O mesmo vale para destinatários de e-mail e para repositórios onde ele pode publicar. Lembre também dos canais sutis: links com dados na query string, imagens carregadas de servidores externos e até pré-visualização de URLs podem servir para tirar informação do sistema sem que ninguém perceba.
Saída de ferramenta é entrada não confiável
Esse é um erro comum e compreensível. A gente confia na saída das ferramentas porque “fui eu que integrei”. Mas o que a ferramenta devolve muitas vezes é conteúdo de terceiros: o corpo de uma página, o texto de um ticket, o resultado de uma busca. Tudo isso deve ser tratado como entrada de usuário anônimo da internet.
Na prática:
- delimite claramente no prompt o que é conteúdo externo e diga ao modelo que aquilo é dado, não instrução (ajuda, mas não garante nada);
- limite o tamanho e o formato do que entra no contexto;
- valide com código determinístico tudo o que o modelo propõe fazer a partir desse conteúdo, antes de executar;
- nunca deixe que o texto externo escolha sozinho argumentos sensíveis, como destinatários, caminhos de arquivo ou comandos.
Logs que permitam entender o que aconteceu
Quando algo dá errado, a pergunta é: “por que o agente fez isso?”. Sem registro, você nunca vai saber. Guarde, respeitando privacidade e retenção adequadas, o contexto que entrou, as ferramentas chamadas, os argumentos, as aprovações humanas e a origem de cada trecho de conteúdo. Logs bons servem para investigar incidentes, para detectar comportamento estranho (um agente de resumo que de repente tenta chamar uma URL desconhecida) e para alimentar novos casos de teste. Só lembre de tratar o próprio log como dado sensível, já que ele vai conter exatamente o que você quer proteger.
Como testar: ataques também são casos de eval
Agora o título do post: o risco que quase ninguém testa. Muita gente tem um conjunto de avaliações para qualidade das respostas, tom, precisão, e nenhum caso adversarial. Se você mede se o agente acerta, também precisa medir se ele resiste.
Algumas ideias para começar sem complicar:
- Monte um pequeno conjunto de documentos envenenados. Um e-mail com instrução embutida, uma página com texto oculto, uma issue com um pedido disfarçado, um PDF com um parágrafo estranho. Varie o tom: ordens explícitas, pedidos educados, falsa urgência, fingir ser o administrador.
- Defina o critério de falha em termos de ação, não de texto. O teste não pergunta “o modelo foi educado?”, e sim “alguma ferramenta sensível foi chamada?”, “algum dado saiu para um destino fora da allowlist?”. Isso é verificável com código simples, olhando as chamadas registradas.
- Coloque um dado-isca. Um segredo falso (um token de mentira) no ambiente de teste. Se ele aparecer em qualquer saída ou requisição, o teste falhou.
- Rode várias vezes. Modelos são probabilísticos. Um ataque que falha nove vezes e funciona na décima ainda é uma vulnerabilidade. Meça taxa de sucesso do atacante, não só um sim ou não.
- Teste cada camada separadamente. Verifique que a allowlist bloqueia mesmo quando o modelo “quer” enviar, que a confirmação humana é de fato exigida, que o escopo do token realmente impede a ação. As defesas que não dependem do modelo são as que você consegue garantir com testes comuns.
- Transforme incidentes e curiosidades em regressão. Todo ataque novo que você ler, ou que aparecer nos logs, vira um caso permanente na suíte. Com o tempo, ela vira a memória de segurança do projeto.
- Rode isso no pipeline. Trocou o modelo, mexeu no prompt de sistema, adicionou uma ferramenta? Rode os casos adversariais de novo. Essas mudanças alteram o comportamento de formas difíceis de prever.
Se possível, peça também para alguém de fora do time tentar quebrar o agente. Quem construiu o sistema tem vieses: tende a testar o que já imaginou. Um olhar criativo e malicioso acha caminhos que a gente nem cogitava.
Limites honestos
Preciso encerrar com franqueza: nenhuma dessas defesas é completa. Filtros de texto malicioso são contornáveis, porque a linguagem natural tem infinitas formas de dizer a mesma coisa. Instruções do tipo “não obedeça ao conteúdo externo” no prompt ajudam, mas modelos podem falhar de forma imprevisível. Detectores baseados em outro modelo também erram, para os dois lados.
Por isso a postura certa não é “como eu impeço 100% das injeções”, e sim “o que acontece quando uma injeção funciona?”. As defesas mais confiáveis são as estruturais, as que limitam o dano mesmo com o modelo comprometido: privilégio mínimo, separação de leitura e escrita, allowlist, confirmação humana, validação determinística. As defesas baseadas em convencer o modelo a se comportar são complementares, nunca a fundação.
E existe um custo real: quanto mais você restringe, menos autônomo e menos “mágico” o agente fica. Cada confirmação humana é atrito. Cada ferramenta removida é uma capacidade a menos. Não há resposta universal; há uma conta a fazer, caso a caso, entre utilidade e risco, considerando o que está em jogo se algo vazar ou for destruído.
Por onde começar na segunda-feira
Se você tem um agente em produção, ou quase, sugiro um roteiro curto:
- Liste as ferramentas do agente e, para cada uma, escreva se ela é de leitura, de escrita ou de saída para fora.
- Desenhe o trio letal: onde há dados privados, onde há conteúdo não confiável, onde há canal de saída. Veja se os três convivem no mesmo fluxo.
- Remova ou separe pelo menos um dos três, e corte permissões que não são necessárias.
- Coloque confirmação humana nas ações irreversíveis e uma allowlist nos destinos.
- Escreva cinco casos de ataque e rode-os junto com os seus evals de qualidade.
- Ligue os logs e dê uma olhada neles de vez em quando, nem que seja por curiosidade.
Nada disso exige tecnologia exótica. Exige, principalmente, aceitar a pergunta incômoda que minha colega ouviu: e se o texto que o agente lê estiver tentando mandar nele? Quem encara essa pergunta cedo costuma dormir melhor depois. E você, já testou o seu agente contra isso?
Autor

flpchapola@hotmail.com
Posts relacionados
Evals para agentes de IA: como saber se a mudança melhorou ou piorou
Parece melhor não é métrica. Veja como montar um conjunto pequeno de casos reais e rodar a cada mudança no seu agente...
Leia tudo
RAG ficou obsoleto? Nove formas de dar conhecimento a uma IA
RAG não ficou obsoleto: ele é uma peça de uma arquitetura maior. Compare nove formas de fornecer conhecimento a uma IA e...
Leia tudo
Agentes de IA com limites: como desenhar autonomia sem perder o controle
Um agente útil não precisa fazer tudo sozinho: limites claros, checkpoints e ferramentas pequenas tornam a autonomia segura e previsível.
Leia tudo
Observabilidade para agentes de IA: como saber o que o agente realmente fez
Resultado certo não prova processo certo. Logs, traces de ferramentas e custo por tarefa para você parar de torcer e começar a...
Leia tudo
Mais código, mesmo software: o gargalo da revisão na era dos agentes de IA
Estudo de Harvard com 300 milhões de eventos mostra: agentes de IA aumentam commits e PRs, mas a revisão humana absorve o...
Leia tudo
Skills vs MCP: quando usar cada um no seu fluxo com agentes de IA
MCP conecta seu agente ao mundo; Skills ensinam o agente a trabalhar do seu jeito. A diferença prática entre ferramentas e receitas...
Leia tudo